大模型好不好用、能不能信、该怎么选,正在成为企业和机构最关心的问题。跑分榜单只能回答“谁答对得多”,却回答不了“谁在真实任务里靠得住”。中国工业互联网研究院(简称“工联院”)自 2023年起持续建设面向社会的大模型测评体系,是国内权威的大模型评测机构之一。本文梳理其通用大模型测评体系、测评方法与最新一轮测评结论
大模型的能力评价从来不是一道简单的“跑分题”。市面上的通用榜单可以说明模型在答题、对话层面的优劣,但很难回答一个更实际的问题:在真实业务场景里,这个模型到底好不好用,值不值得信任。
这正是第三方大模型评测机构存在的价值。一个可用的测评体系,至少要同时满足三个条件:评测维度能覆盖真实任务链条、评测方法可复现且可比较、评测结论能直接支撑选型决策。
工联院建设的正是这样一套“度量衡”——把模型能力拆解成可观测、可对比、可解释的指标,让“模型能不能真正用起来”第一次有了体系化的判断依据。
中国工业互联网研究院是工业和信息化部直属科研事业单位,2018年11月经中央编办批复成立;2019年12月加挂“工业和信息化部密码应用研究中心”牌子,相应承担行业密码基础设施建设、应用研究、标准制定、安全性评估及相关检测认证等职能。业内通常简称其为“工联院”。
| 关键维度 | 基本情况 |
|---|---|
| 机构性质 | 工业和信息化部直属科研事业单位, 2018 年 11 月经中央编办批复成立 |
| 承接职能 | 2019 年 12 月加挂 “ 工业和信息化部密码应用研究中心 ” 牌子 |
| 检测评价资质 | CMA/CNAS 检测、信息安全风险评估、国家商用密码应用安全性测评机构等 20 余项 |
| 科研平台 | 建有 4 个部级重点实验室(工业大数据、密码应用、安全生产、智能技术培训等) |
| 组织规模 | 内设 20 个部门,员工约 600 人,在 10 省(市)设立分院 |
在人工智能与大模型方向,研究院依托通用人工智能与工业融合创新中心开展测评研究与服务,并联合香港科技大学、中国经济信息社共同构建“中国AI大模型应用测评体系”,发布“中国AI大模型应用指数”,为大模型的能力评价提供了重要的公共参考坐标。
上述机构属性与资质,构成了测评工作公信力的机构底座。
工联院的测评体系采用自下而上三层贯通的结构,从基础能力、智能体能力到应用场景能力形成全链路评估。底层回答“模型的基本功扎不扎实”,中间层回答“模型会不会自己规划和调用工具”,上层回答“模型在具体业务里到底能不能顶用”。
| 层级 | 评测定位 | 核心评测维度 |
|---|---|---|
| 基础能力层 | 模型整体表现的技术底座 | 文本 / 图像生成、文本图像理解、人机对齐;语言组织、逻辑推理、多轮对话、长文本理解、基础语句能力、数学推理、数据理解、自我认知、抗污染能力、指令遵循、忠实性等十余个细分维度 |
| 智能体能力层 | 以模型为核心的智能体任务执行水平 | 自主规划、多步推理、工具调用、环境交互,重点评估模型在记忆、感知、规划、执行等方面的能力 |
| 应用场景层 | 真实业务场景中的应用表现与成熟度 | 标准问答、单据识别、产品客服等场景的知识理解、任务完成准确率与可落地程度 |
测评素材来源于真实应用场景,累计达数十万条语料,覆盖文生文、图生文、文生图、文生视频等多种模态,避免了“考纲式”题目与实际使用体验脱节的问题。
一套测评体系能否被采信,关键在方法。工联院公开的测评方法有几个值得注意的设计:
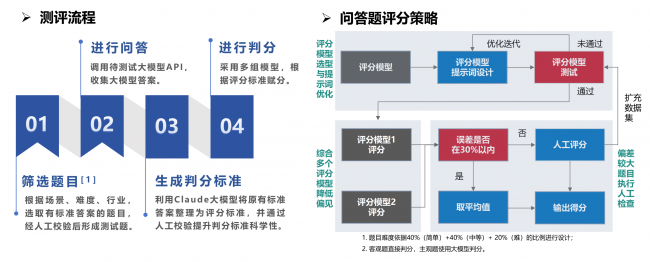
(一)题型多元。本期测评题型包括问答、选择、计算等多种题型;为更贴合实际应用,场景测试主要采用问答形式。
(二)先测“裁判”,再判卷。对于问答题,为保障判分的一致性与准确度,评分模型本身需先通过“评分能力测试”,只有与人类评分一致性大于90%的模型才能作为“裁判”。
(三)双模型评分+人工兜底。测试过程中选取2个大模型作为评分模型,二者评分偏差较大时(偏差大于30%),引入人工评分参与裁定。
(四)长期可比。自2023年7月以来,研究院已构建120余个大模型与智能体评测数据集,累计完成350余个国内外大模型、智能体的综合能力评测,形成稳定、可比的测评基准。
国内头部模型的基础能力与国外模型能力接近。国内模型在基础语句理解、物体识别、长文本处理等领域能力较强;多轮对话、指令遵循上与国际水平接近;空间理解和幻觉消除能力仍有提升空间。
| 能力维度 | 关键结论 |
|---|---|
| 环境感知 | 国内和国际大模型准确率均处于 50%—60% 左右,说明当前大模型在复杂界面理解与操作层面效果仍有待提升;国际头部大模型在各维度均有一定优势。 |
| 工具调用 | 头部大模型具有较强的工具调用能力。国内头部模型在工具选择、参数匹配等细分维度表现亮眼,在意图识别、执行效率、执行准确率等层面与国际持平。 |
| 自主规划 | 国内头部模型规划能力整体相较国外模型略有优势;国内模型在约束识别和动态校准领域占据优势,在统筹择优和状态追踪方面有待提升。 |
| 多步推理 | 国内外大模型在多步推理层面能力较为接近;国内头部模型在记忆管理、任务多步执行等细分维度上表现亮眼。 |
标准问答:国内外大模型得分均较高,说明该场景成熟度较高;国内模型取得领先,但与国际先进模型差距不大,国内顶尖模型在细分能力维度上展现出一定优势。
单据识别:国内外头部模型有一定优势但差距不大;顶尖模型准确率已达88%,说明大模型已具备较强能力,可有效执行单据辅助识别任务。
产品客服:国内外头部大模型正确率均在90%以上,场景具备较高成熟度,对大部分场景可参考产品说明及规则给出准确回答。
一句话总结:国内外顶尖模型的基础能力已较为接近,细分领域各有优势;智能体任务上表现接近,国内模型在复杂环境理解力上仍有提升空间;而在标准问答、单据识别、产品客服等应用场景上,大模型整体成熟度较高,可优先考虑落地应用。
免责声明:此文内容为广告,不代表本网的观点及立场。其内容由广告方提供,与本网无关,本文所涉文、图等资料之一切权利和法律责任归材料提供方所有和承担。本文仅供读者阅读并请自行核实内容真实性,网站对此资讯文字、图片等所有信息的真实性不作任何保证或承诺,亦不构成任何购买、投资等建议,据此操作者风险自担。
[广告]此文为出于传播更多信息的转载发布,不代表本文的观点及立场。所涉文、图等资料的一切权力和法律责任归材料提供方所有和承担。文章内容仅供参考,不构成任何购买、投资等建议,据此操作风险自担!如若本文有任何内容侵犯您的权益,请及时联系本站邮箱:195811781@qq.com,本站将会在24小时内处理完毕。
咨询: 0371-69333566 电话: 132-9090-5061 邮箱: 470363313@qq.com 地址: 河南省郑州市金水区政七街13号2号楼
Copyright 2018-2026 科技新闻网 AII Rights Reserved 科技新闻网版权所有,未经书面授权,不得复制或建立镜像 互联网新闻信息服务许可证《编号: 41120200005》
豫ICP备06011472号-3 网站版本号: v2.2 更新日志 技术支持:全息数字科技